Chapter 3. 신경망
과제
3 - 1. 퍼셉트론에서 신경망으로
퍼셉트론은 복잡한 함수도 표현할 수 있지만 가중치를 설정하는 작업은 여전히 사람이 수동으로 한다는 단점이 존재한다. 하지만 신경망은 가중치 매개변수의 적절한 값을 데이터로부터 자동으로 학습하는 능력을 갖추고 있다
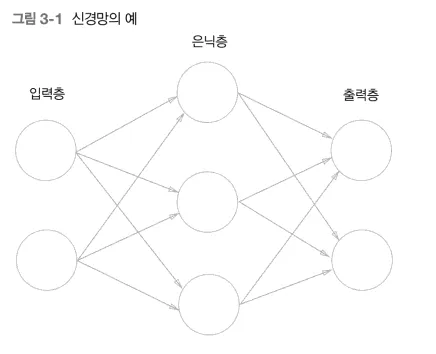
왼쪽 줄을 입력층, 중간 줄을 은닉층, 오른쪽 줄을 출력층이라고 한다
은닉층이라 부르는 이유는 사람의 눈에 직접적으로 보이지 않는 부분이기 때문이다
위에 그림 3-1은 앞 장에서 본 퍼셉트론과 크게 달라 보이지 않는다. 실제로 뉴런의 연결 방식은 달라진것이 없다 다만 신호를 전달하는 방법에서 차이가 발생한다.
3 - 2. 활성화 함수
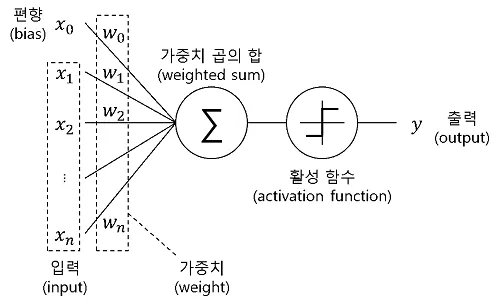
활성화 함수란 입력 신호의 총합이 활성화를 일으키는지를 정하는 역할을 한다. 활성화 함수가 필요한 이유는 모델의 복잡도를 올리기 위함인데 비선형 문제를 해결하는데 중요한 역할을 한다, 비선형 문제를 해결하기 위해 단층 퍼셉트론을 쌓는 방법을 이용헀는데 은닉층을 무작정 쌓기만 한다고해서 비선형문제를 해결할 수 있는것은 아니다. 활성 함수를 사용하면 입력값에 대한 출력값이 비선형적으로 나오므로 선형분류기를 비선형분류기로도 만들 수 있다.
3 - 2 - 1. 시그모이드 함수
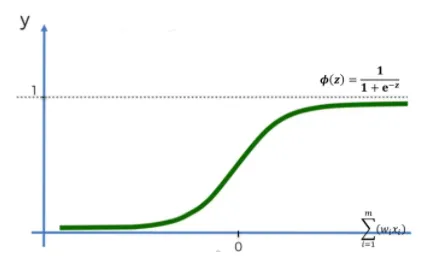
신경망에서는 가중치를 학습시키는데 있어 미분을 사용해야했기 때문에 활성화 함수로 계단함수를 사용할 수 없었다. 또한 계단함수는 0과 1과 같은 극단적인 값을 전달하기 때문에 데이터의 정보를 손실시켰다, 따라서 계단함수를 곡선의 형태로 변형시킨 형태의 시그모이드 함수를 적용하게 되었다. 시그모이드는 우리가 흔히 알고 있는 로지스틱 함수이다.
3 - 2 - 2. 함수 구현하기
시그모이드 함수구현
import numpy as npimport matplotlib.pylab as plt
def sigmoid(x): return 1 / (1 + np.exp(-x))
x = np.arange(-5.0,5.0,0.1)y = sigmoid(x)plt.plot(x, y)plt.ylim(-0.1, 1.1)plt.show()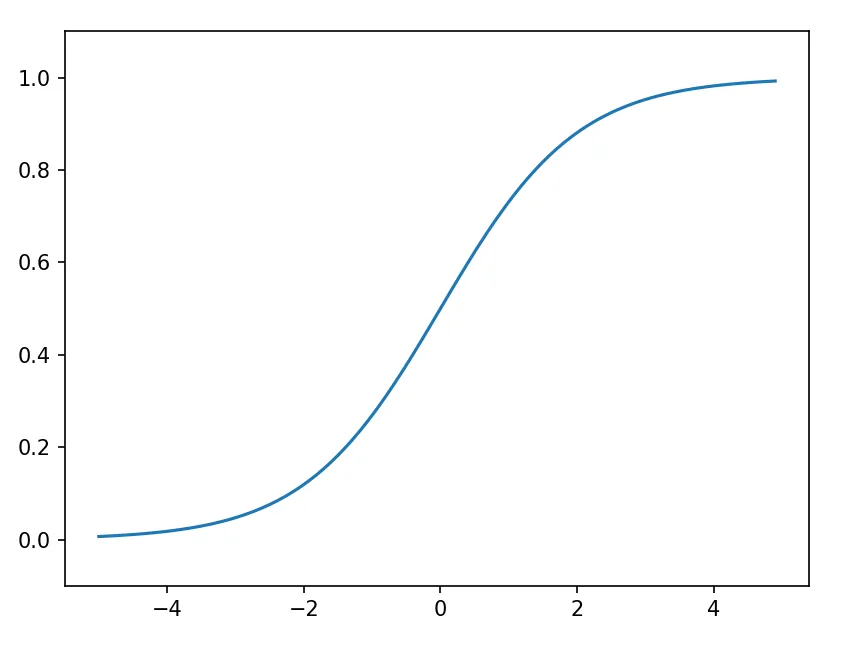
시그모이드 함수와 계단 함수를 비교해보면 가장 눈에 띄는 차이는 ’매끄러움’의 차이이다 시그모이드 함수는 부드러운 곡선이고 입력에 따라 출력이 연속적으로 변화한다. 계단함수는 0을 경계로 출력이 갑자기 바뀌어버린다.
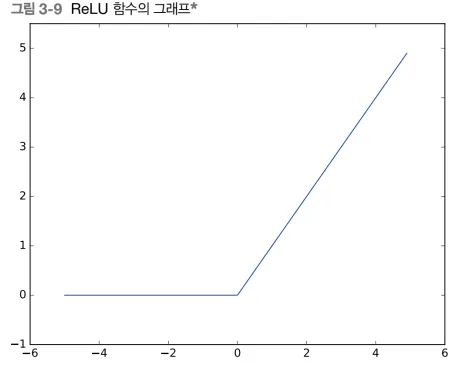
3 - 2 - 3. ReLU 함수
최근에 주로 사용되는 ReLU함수이다 입력이 0을 넘으면 그 입력을 그래도 출력하고, 0이하이면 0을 출력하는 함수이다.
3 - 3. 3층 신경망 구현하기
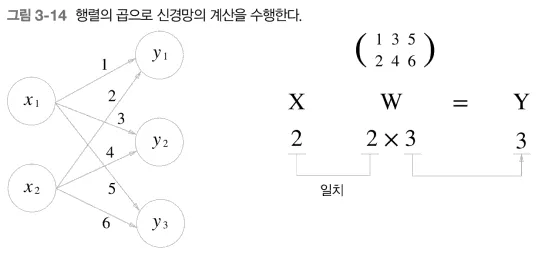
넘파이 행렬을 통해 신경망을 구현
코드로 나타내면 다음과 같다
import numpy as np
X = np.array([1,2])W = np.array([[1,3,5],[2,4,6]])Y = np.dot(X,W) # 행렬의 곱print(Y)이를 기반으로 입력층에서 1층으로 신호가 전달되는 것을 그림으로 나타냄
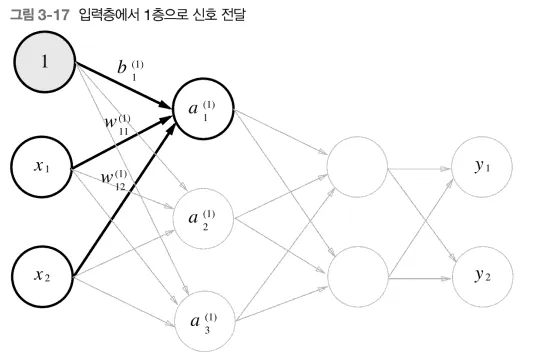
1층의 a를 식으로 나타내면 아래와 같다
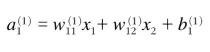
행렬의 곱을 이용하여 1층의 가중치 부분을 간소화 할수 있고 행렬을 각각 정리해보면
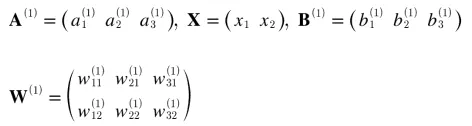
이렇게 정리가 되고 다차원 배열의 곱셈을 이용하여 a를 구하는 코드는 아래와 같다
import numpy as np
X = np.array([1.0,0.5])W1 = np.array([[0.1,0.3,0.5],[0.2,0.4,0.6]])B1 = np.array([0.1,0.2,0.3])
A1 = np.dot(X,W1) + B1print(A1)이때 1층의 활성화 함수에서의 처리는 다음과 같이된다
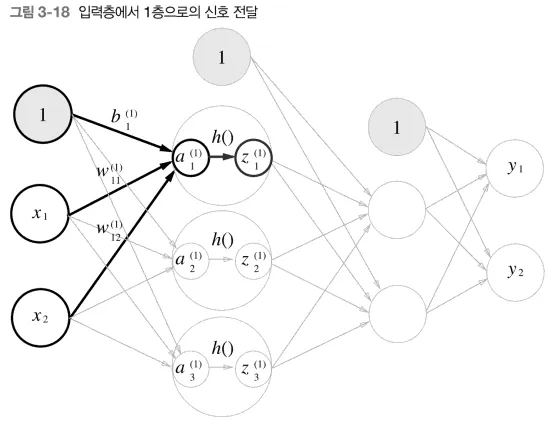
은닉층에서의 가중치 합을 a로 표기하고 활성화 함수 h()로 변환된 신호를 z로 표기한다. 여기에서는 활성화 함수로 시그모이드 함수를 사용한다
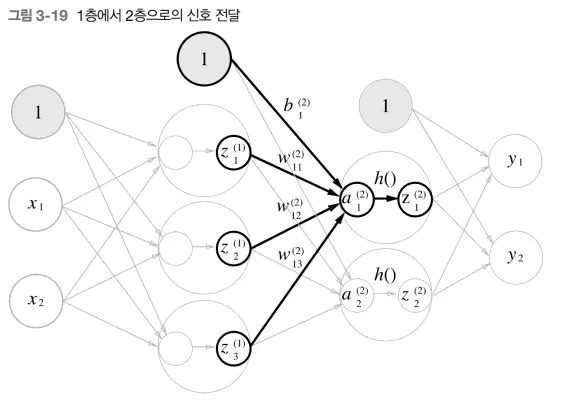
1층에서 2층은 방금전 구현에서 1층의 출력 Z1이 2층의 입력이 된다는 점을 제외하면 똑같다
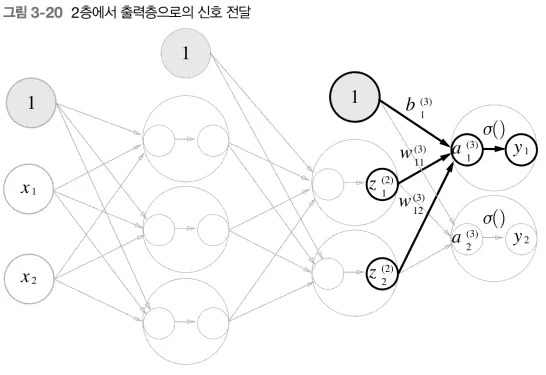
마지막으로 2층에서 출력층으로의 신호 전달이다 출력층의 구현도 그동안의 구현과 거의 다를바없다. 활성화 함수만 지금까지의 은닉층과 다르다
3 - 3. 구현정리
def init_network(): network = {} network['W1'] = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]]) network['b1'] = np.array([0.1, 0.2, 0.3]) network['W2'] = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]]) network['b2'] = np.array([0.1, 0.2]) network['W3'] = np.array([[0.1, 0.3], [0.2, 0.4]]) network['b3'] = np.array([0.1, 0.2])
return network
def forward(network, x): W1, W2, W3 = network['W1'], network['W2'], network['W3'] b1, b2, b3 = network['b1'], network['b2'], network['b3']
a1 = np.dot(x, W1) + b1 z1 = sigmoid(a1) a2 = np.dot(z1, W2) + b2 z2 = sigmoid(a2) a3 = np.dot(z2, W3) + b3 y = identity_function(a3)
return y
network = init_network()x = np.array([1.0, 0.5])y = forward(network, x) # [ 0.31682708 0.69627909]
print(y)3 - 4. 출력층 설계하기
신경망은 분류와 회귀 모두에 이용할 수 있다. 둘중 어떤 문제냐에 따라서 출력층에 사용하는 활성화 함수가 달라지게 된다. 일반적으로 회귀에는 항등 함수를, 분류에는 소프트맥트 함수를 사용한다.
3 - 4 - 1. 항등함수와 소프트맥스 함수
항등함수는 입력을 그래도 출력한다 그래서 출력층에서 항등함수를 사용하면 입력 신호가 그대로 출력되게 된다
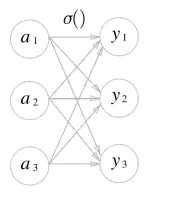
분류에서 사용하는 소프트맥스 함수의 식은 아래와 같다
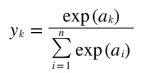
그림으로 나타내면 다음과 같다
import numpy as np
def softmax(a): c = np.max(a) exp_a = np.exp(a-c) sum_exp_a = np.sum(exp_a) y = exp_a / sum_exp_a return y
a = np.array([0.3,2.9,4.0])y = softmax(a)print(y)sum = np.sum(y)print(sum)내 생각
아직까지 학습을 진행해본것이 아니라 퍼셉트론과의 큰 차이가 느껴지진않았고 “학습한다”라는 말때문인지 기대했던것과 달리 결국 숫자의 연산이였고 그 숫자를 어디서 가져와서 연산하는지인 것 같다. 지능이라는 단어를 붙이기에는 아직 너무 단순한 느낌이다.