Chapter 4. 신경망 학습
과제
학습이란 훈련 데이터로부터 가중치 매개변수의 최적값을 자동으로 획득하는 것을 뜻한다. 신경망이 학습할 수 있도록 해주는 지표인 손실 함수의 내용이 나온다. 손실 함수의의 결괏값을 가장 작게 만드는 가중치 매개변수를 찾는 것이 학습의 목표이다. 손실 함수의 값을 작게 만드는 기법으로 함수의 기울기를 활용하는 경사법이 나온다.
4 - 1. 데이터에서 학습한다
신경망의 특징은 데이터를 보고 학습할 수 있다는 점이다. 데이터에서 학습한다는 것은 가중치 매개변수의 값을 데이터를 보고 자동으로 결정한다는 것이다. 이전 장에서는 진리표를 보며 사람이 직접 매개변수 값을 설정했다. 학습단계이기때문에 매개변수가 3개밖에 되지않았지만 실제 신경망에서는 매개변수가 셀수 없이 많아진다. 이러한 이유로 매개변수를 수작업으로 정하기는 아예 불가능하다.
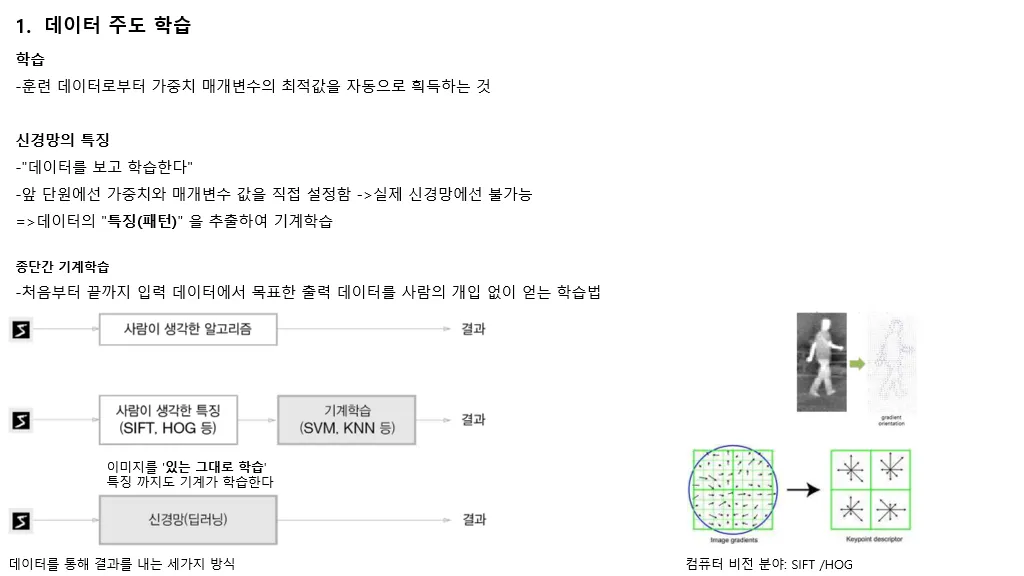
위의 그림과 같이 신경망은 이미지를 있는 그대로 학습한다.
4 - 1 - 1. 데이터 학습 과정 주의사항
데이터 학습과정
- 훈련 데이터만 사용하여 학습하면서 최적의 매개변수(가중치, 편향)를 찾는다
- 시험 데이터를 이용하여 훈련된 모델의 성능을 평가
데이터를 나누지 않을 경우?
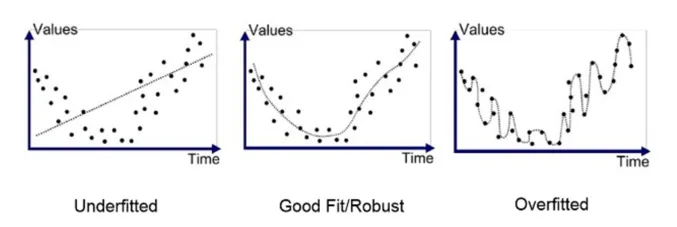
- 우리가 원하는 것은 범용적으로 사용할 수 있는 모델
- 학습한 데이터 셋에만 지나치게 최적화 되어 새로운 데이터에 대한 성능은 떨어진다
-> 오버피팅(Overfitting)
4 - 2. 손실 함수
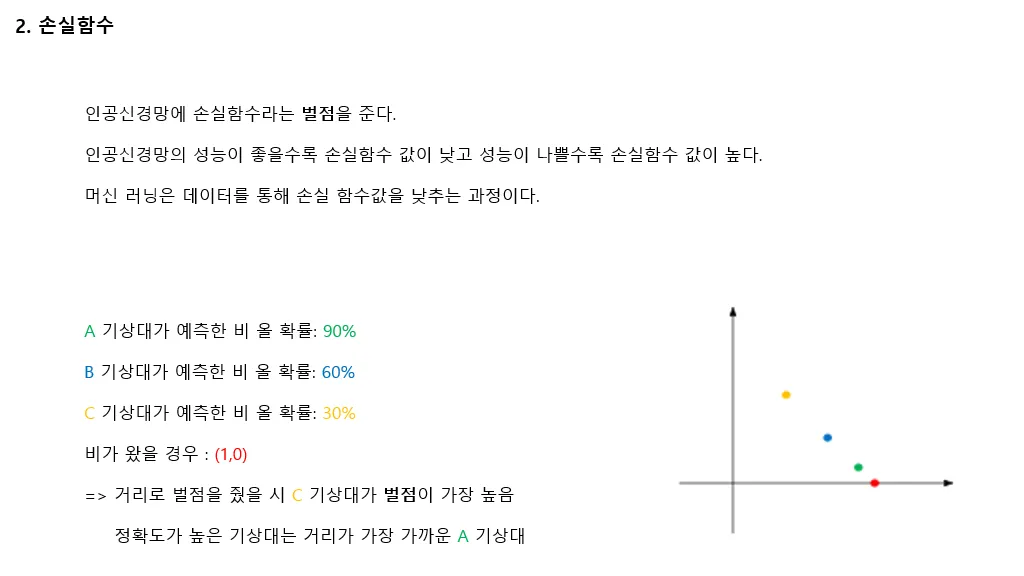
인공신경망을 학습하는 과정에서 가이드라인의 역할을 하는 손실함수이다.
손실함수는 벌점이다. 인공신경망의 성능이 좋을수록 손실함수 값이 낮고 성능이 나쁠수록 손실함수 값이 높다
머신 러닝은 데이터를 통해 손실 함수값을 낮추는 과정이다.
손실 함수는 임의의 함수를 사용할 수도 있지만 일반적으로는 오차제곱합과 교차 엔트로피 오차를 사용한다
4 - 2 - 1. 오차제곱합
가장 많이 쓰이는 손실 함수는 오차제곱합(SSE)이다 수식으로는 다음과같다.
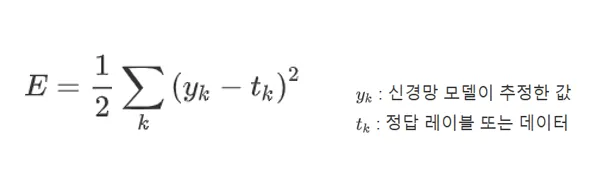
데이터가 신경망을 거쳐 나온확률 벡터와 라벨을 인코딩하여 나온 확률벡터를 고차원 공간의 점으로 이해한 후 피타고라스 정리로 거리를 측정한다.
나중에 미분 계산의 편의를 위해 제곱근은 없애고 앞에 2로 나눈다. 데이터 셋의 평균 제곱 오차는 각 데이터의 평균 제곱 오차의 평균으로 정의
4 - 2 - 2. 교차 엔트로피 오차
또 다른 손실 함수로서 교차 엔트로피 오차도 자주 이용한다
교차 엔트로피 오차란 확률분포사이의 거리를 재는 방법이다 T(x)는 정답에 해당하는 인덱스 원소만 1이고 나머지는 0이다. 실제로 정답일 때의 추정의 계산만 하면 된다
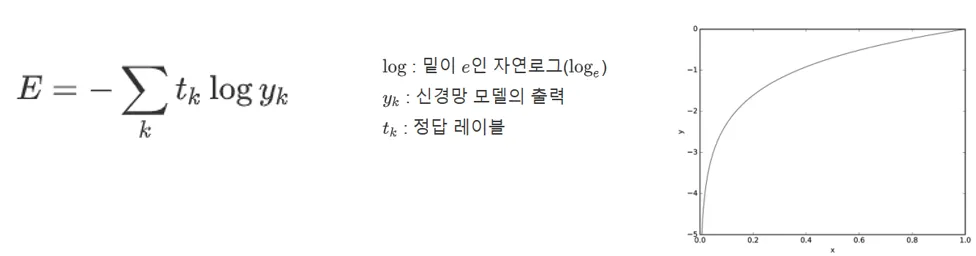
함수구현은 다음과 같다
def cross_entropy_error(y, t): delta = 1e-7 return -np.sum(t * np.log(y + delta))4 - 2 - 3. 미니배치 학습
미니배치한 훈련 데이터로부터 일부만 골라 학습을 수행한다
실제 딥러닝은 미니배치 학습을 하기 때문에 미니배치 크기만틈의 데이터에 대한 각각의 손실함수의 평균을 내어 평균 손실 함수를 계산한다
데이터 하나에 대한 손실함수에서 단순히 N개의 데이터로 확장한 방식이다 다만 마지막에 N으로 나누어 정규화한다
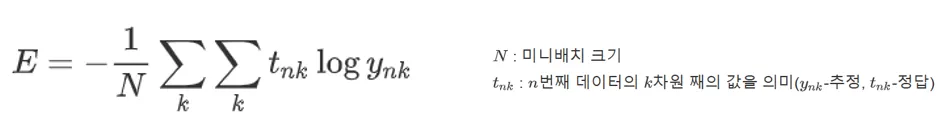
import numpy as npimport sysimport ossys.path.append(os.pardir)from dataset.mnist import load_mnist
# 4.2.3 미니배치 학습# 훈련 데이터 전체에 대한 오차함수# E = -1/N * ∑ _n (∑ _k (tk * log(yk)))# N : 데이터의 개수# 훈련 데이터 전체에 대한 손실 함수를 계산하기에는 시간이 오래걸리기 때문에# 일부를 추려 전체의 근사치로 이용할 수 있다.(x_train, t_train), (x_test, t_test) = \ load_mnist(normalize=True, one_hot_label=False)
print(x_train.shape) # (60000, 784)print(t_train.shape) # 원-핫 인코딩 된 정답 레이블 (60000, 10)
# 무작위 10개 추출train_size = x_train.shape[0]batch_size = 10batch_mask = np.random.choice(train_size, batch_size)x_batch = x_train[batch_mask]t_batch = t_train[batch_mask]
# 4.2.4 (배치용) 교차 엔트로피 오차 구현하기def cross_entropy_error(y, t): if y.ndim == 1: t = t.reshape(1, t.size) y = y.reshape(1, y.size)
batch_size = y.shape[0] return -np.sum(t * np.log(y[np.arange(batch_size), t])) / batch_size
# 4.2.5 왜 손실 함수를 설정하는가?# 신경망을 학습할 때 정확도를 지표로 삼아서는 안 된다.# 정확도를 지표로 하면 매개변수의 미분이 대부분의 장소에서 0이 되기 때문이다.# (매개변수의 미소한 변화에는 거의 반응을 보이지 않고 그 값이 분연속적으로 변화)4 - 2 - 5. 왜 손실 함수를 설정하는가?
왜 손실 함수를 사용할까? 정확도에 대한 값을 사용하면 되지않을까?라는 의문이 생길 수 있다
이는 ’미분’의 역할에 주목한다면 해결된다.
- 신경망 학습에서 최적의 매개변수를 탐색할 때 손실 함수의 값을 가장 작게 하는 매개변수를 찾게 된다 이때 매개변수 미분(기울기)를 계산하고, 그 미분 값을 서서히 갱신하는 과정을 반복하게 된다
가중치 매개변수의 값을 아주 조금 변화 시켰을 때, 손실 함수가 어떻게 변하는가?
정확도를 지표로 삼으면 매개변수의 미분이 대부분의 장소에서 0이 된다 예를 들어 100장의 훈련데이터 중 32장을 올바로 인식할 시 정확도는 32%, 매개변수의 작은 변화에는 반응이 없을 것이며 33%, 35%처럼 불역속적인 값이 나오게 될 것이다 그러므로 미분이 되지않는다.
4 - 3. 경사하강법
기계학습에서 가장 기본적으로 사용되는 최적화 알고리즘이다 손실합수를 최소화하는 최적의 매개변수를 찾는데 사용된다.
원리는 현재 위치에서 기울기가 가리키는 방향으로 일정 거리만틈 이동하면서 손실 함수값을 줄여간다 (극값에 이를 때 까지 반복하여 최소의 근사값을 찾는다)
손실함수 미분이 아닌 경사하강법을 사용하는 이유는 실제 우리가 마주하는 함수들은 복잡하고, 비선형적인 함수들이다 그러므로 경사 하강법을 구현하여 최솟값을 찾는 것이 효율적이다
4 - 3 - 1. 경사 하강법으로 근사값을 찾는 과정
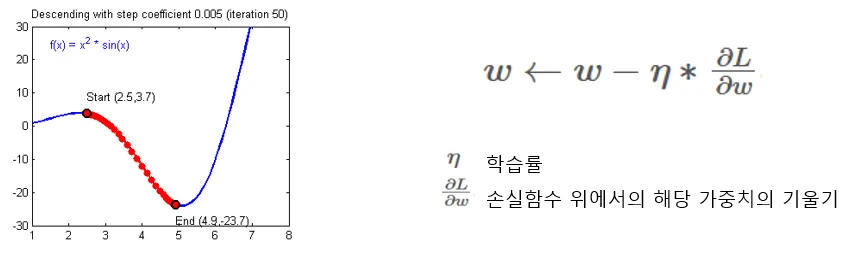
- 현재 위치가 음수라면 매개변수를 증가시켜 최소값 발견
- 반대로 기울기가 양수라면 매개변수를 감소시켜 최솟값 발견
-> 해당 매개변수에서 학습률을 빼면 최솟값이 되는 장소를 찾을 수 있다
기울기가 가리키는 곳에 최소값이 있을지, 맞는 방향으로 나아가는지를 보장은 할 수 없다 하자만 그 방향으로 가야 함수의 값을 줄일 수 있는 것은 확정적이다
4 - 3 - 2. 신경망에서의 기울기
신경망 학습에서도 가중치 매개변수에 대한 손실 함수의 기울기를 구해야한다 예를 들어 2x3, 가중치가 W, 손실 함수가 L인 신경망을 생각해보면 수식으로는 다음과 같다
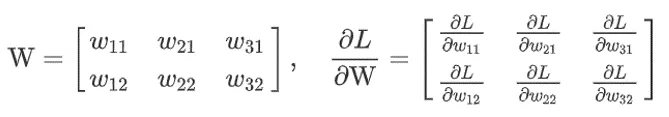
import sysimport osimport numpy as npsys.path.append(os.pardir)from common.functions import softmax, cross_entropy_errorfrom common.gradient import numerical_gradient
# 4.4.2 신경망에서의 기울기class simpleNet: """docstring for simpleNet""" def __init__(self): self.W = np.random.randn(2, 3) # 정규분포로 초기화
def predict(self, x): return np.dot(x, self.W)
def loss(self, x, t): z = self.predict(x) y = softmax(z) loss = cross_entropy_error(y, t)
return loss
net = simpleNet()print(net.W) # 가중치 매개변수(랜덤)x = np.array([0.6, 0.9])p = net.predict(x)print(p)print(np.argmax(p)) # 최댓값의 인덱스
t = np.array([0, 0, 1]) # 정답 레이블print(net.loss(x, t))
def f(W): return net.loss(x, t)
dW = numerical_gradient(f, net.W)print(dW)내 생각
1. 오답에 대한 손실 함수별 벌점 차이
정답 클래스의 예측 확률이 0.1인 경우와 0.01인 경우의 손실값을 비교하였다.
- 오차제곱합(SSE): 정답 원소 항만 보면 0.5×(1−0.1)² ≈ 0.41에서 0.5×(1−0.01)² ≈ 0.49로 소폭 증가하는 데 그쳤다.
- 교차 엔트로피 오차(CEE): −log 0.1 ≈ 2.30에서 −log 0.01 ≈ 4.61로 약 두 배 증가하였다.
즉, CEE는 모델이 확신을 가지고 틀릴수록 훨씬 큰 벌점을 부여한다. 분류 문제에서 교차 엔트로피 오차가 주로 사용되는 이유가 이러한 특성에 있다고 판단된다.
2. 수치 미분의 연산 비용과 임베디드 환경에서의 적용 가능성
numerical_gradient는 매개변수 하나당 순전파를 두 번씩 수행한다. 본 장의 simpleNet은 매개변수가 6개에 불과해 연산이 금방 끝난다. 그러나 MNIST 분류용 신경망만 해도 매개변수가 수만 개에 달해 PC 환경에서도 비효율적인 방식이다. RAM이 수백 KB, 클럭이 수백 MHz 수준인 MCU에서는 이 방식으로 학습하는 것이 사실상 불가능하다.
따라서 TinyML 분야에서는 학습은 PC에서 수행하고, MCU에는 학습된 가중치만 탑재해 추론만 수행하는 구조가 일반적이다. 기울기를 보다 효율적으로 계산하는 방법으로 다음 장에서 오차역전파법을 다룬다. 이후 수치 미분과 오차역전파법의 연산량을 직접 비교해 볼 계획이다.